合适的计算网络架构是能够支撑目标应用、并且可由负责团队可靠运维的那一个。协议选择或交换机代际只是该决策的一部分。先从工作负载行为和服务器集成入手,再评估完整的受支持配置。
在比较协议之前先描述通信
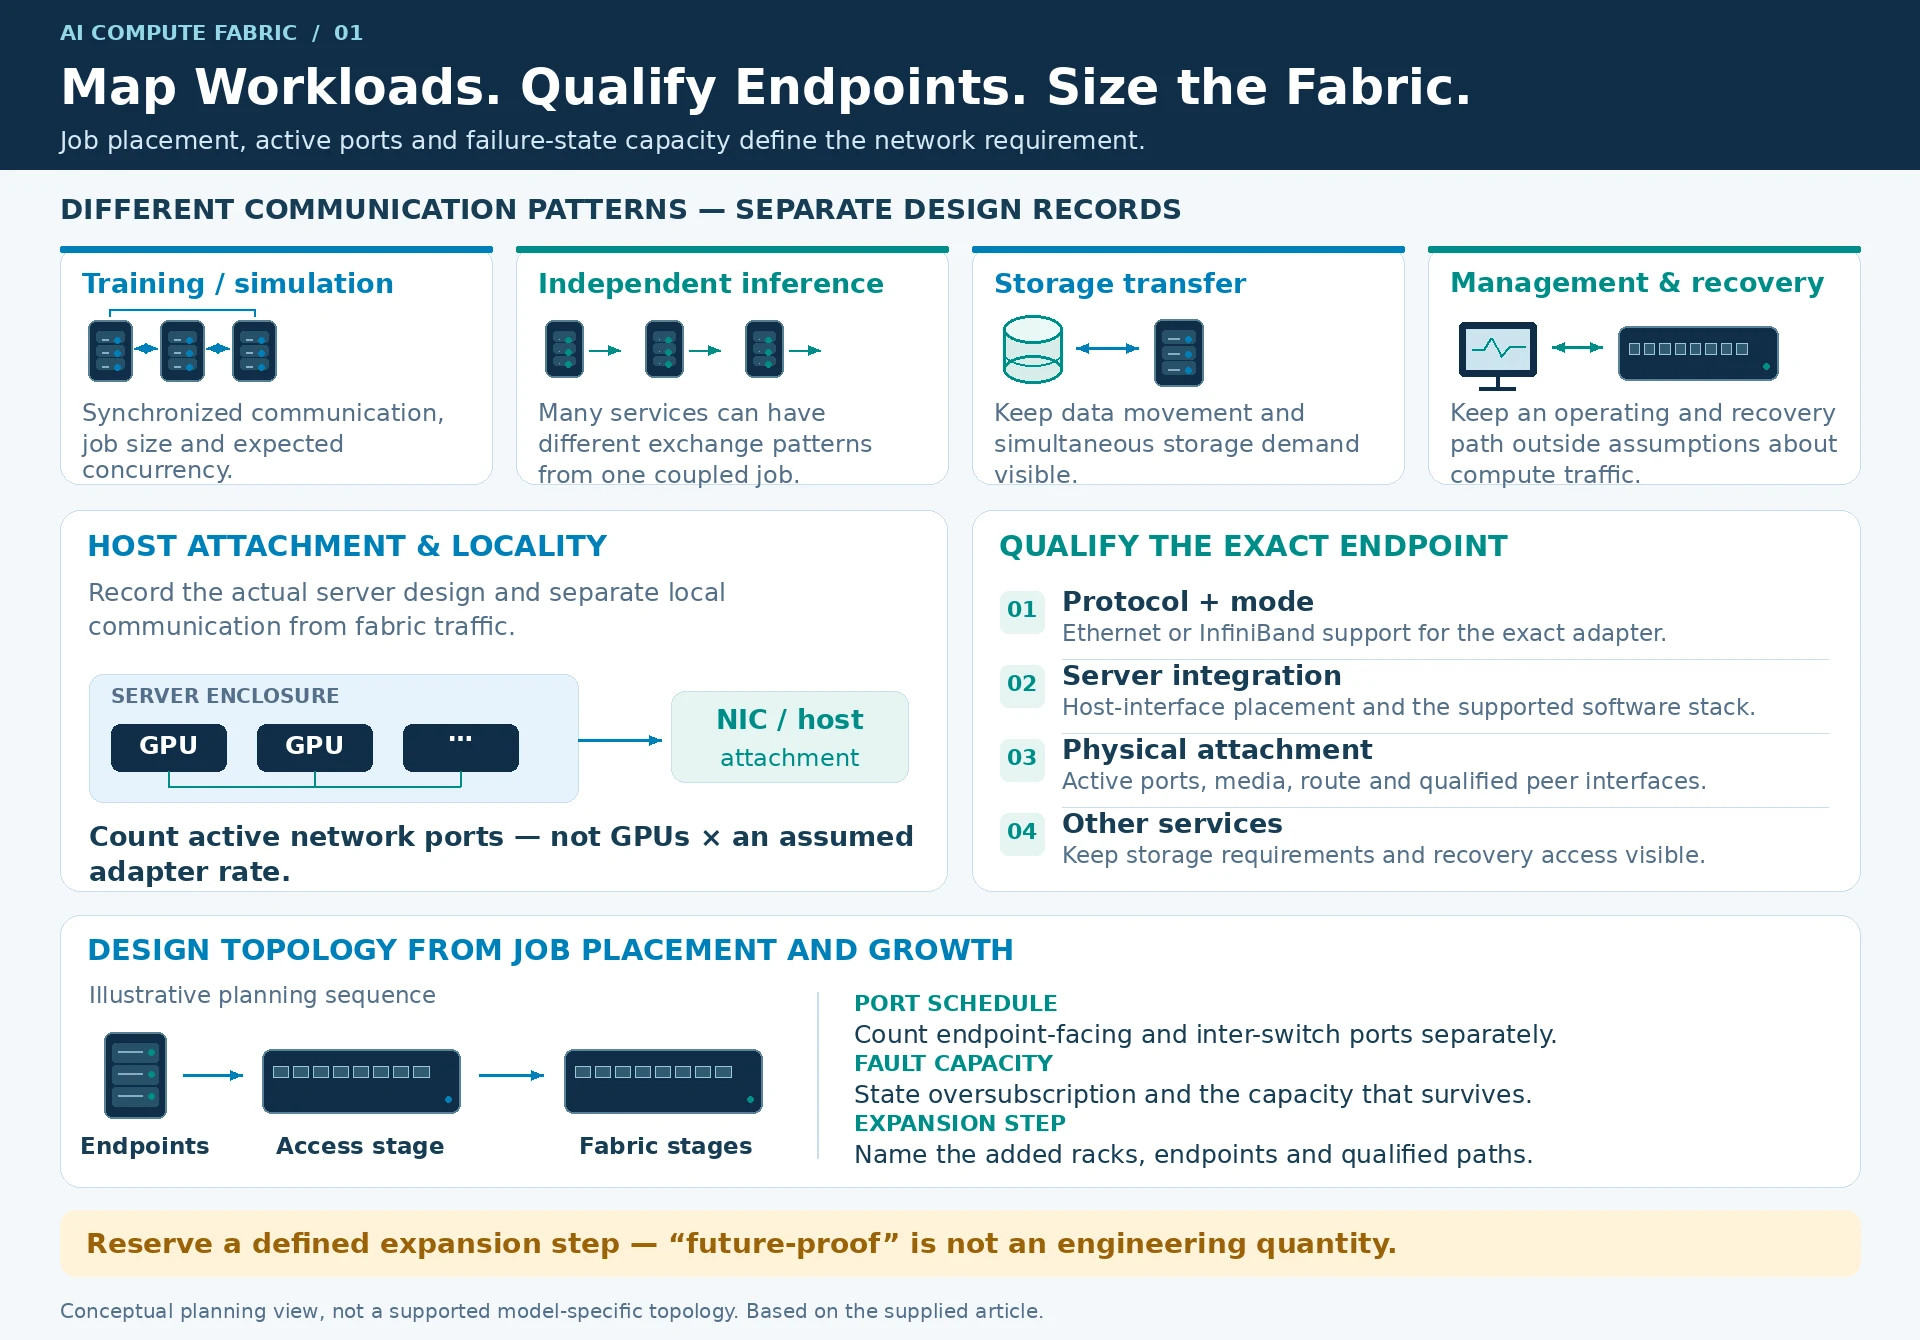
确定该环境是以同步训练集合通信、分布式仿真、推理服务、存储传输还是混合负载为主。记录预期的作业规模和并发度。将服务器内部的通信与必须跨网络传输的业务流量区分开。
一个运行大量独立推理服务的示例集群,其流量模式可能与在相同 GPU 数量上运行单个紧耦合训练作业的集群不同。GPU 数量相同并不意味着网络需求相同。
统计受支持的端点数量
清点确切的服务器和适配器型号、主机接口位置以及所需的工作模式。以太网和 InfiniBand 的支持必须针对具体适配器来确认,而不能根据宽泛的系列名称推断。ConnectX 文档是进行此类主机验证的起点。R51
让存储和管理需求保持可见。计算网络架构的决策不应让团队失去恢复路径,也不应假设所有服务都使用同一协议。
比较完整的运行模式
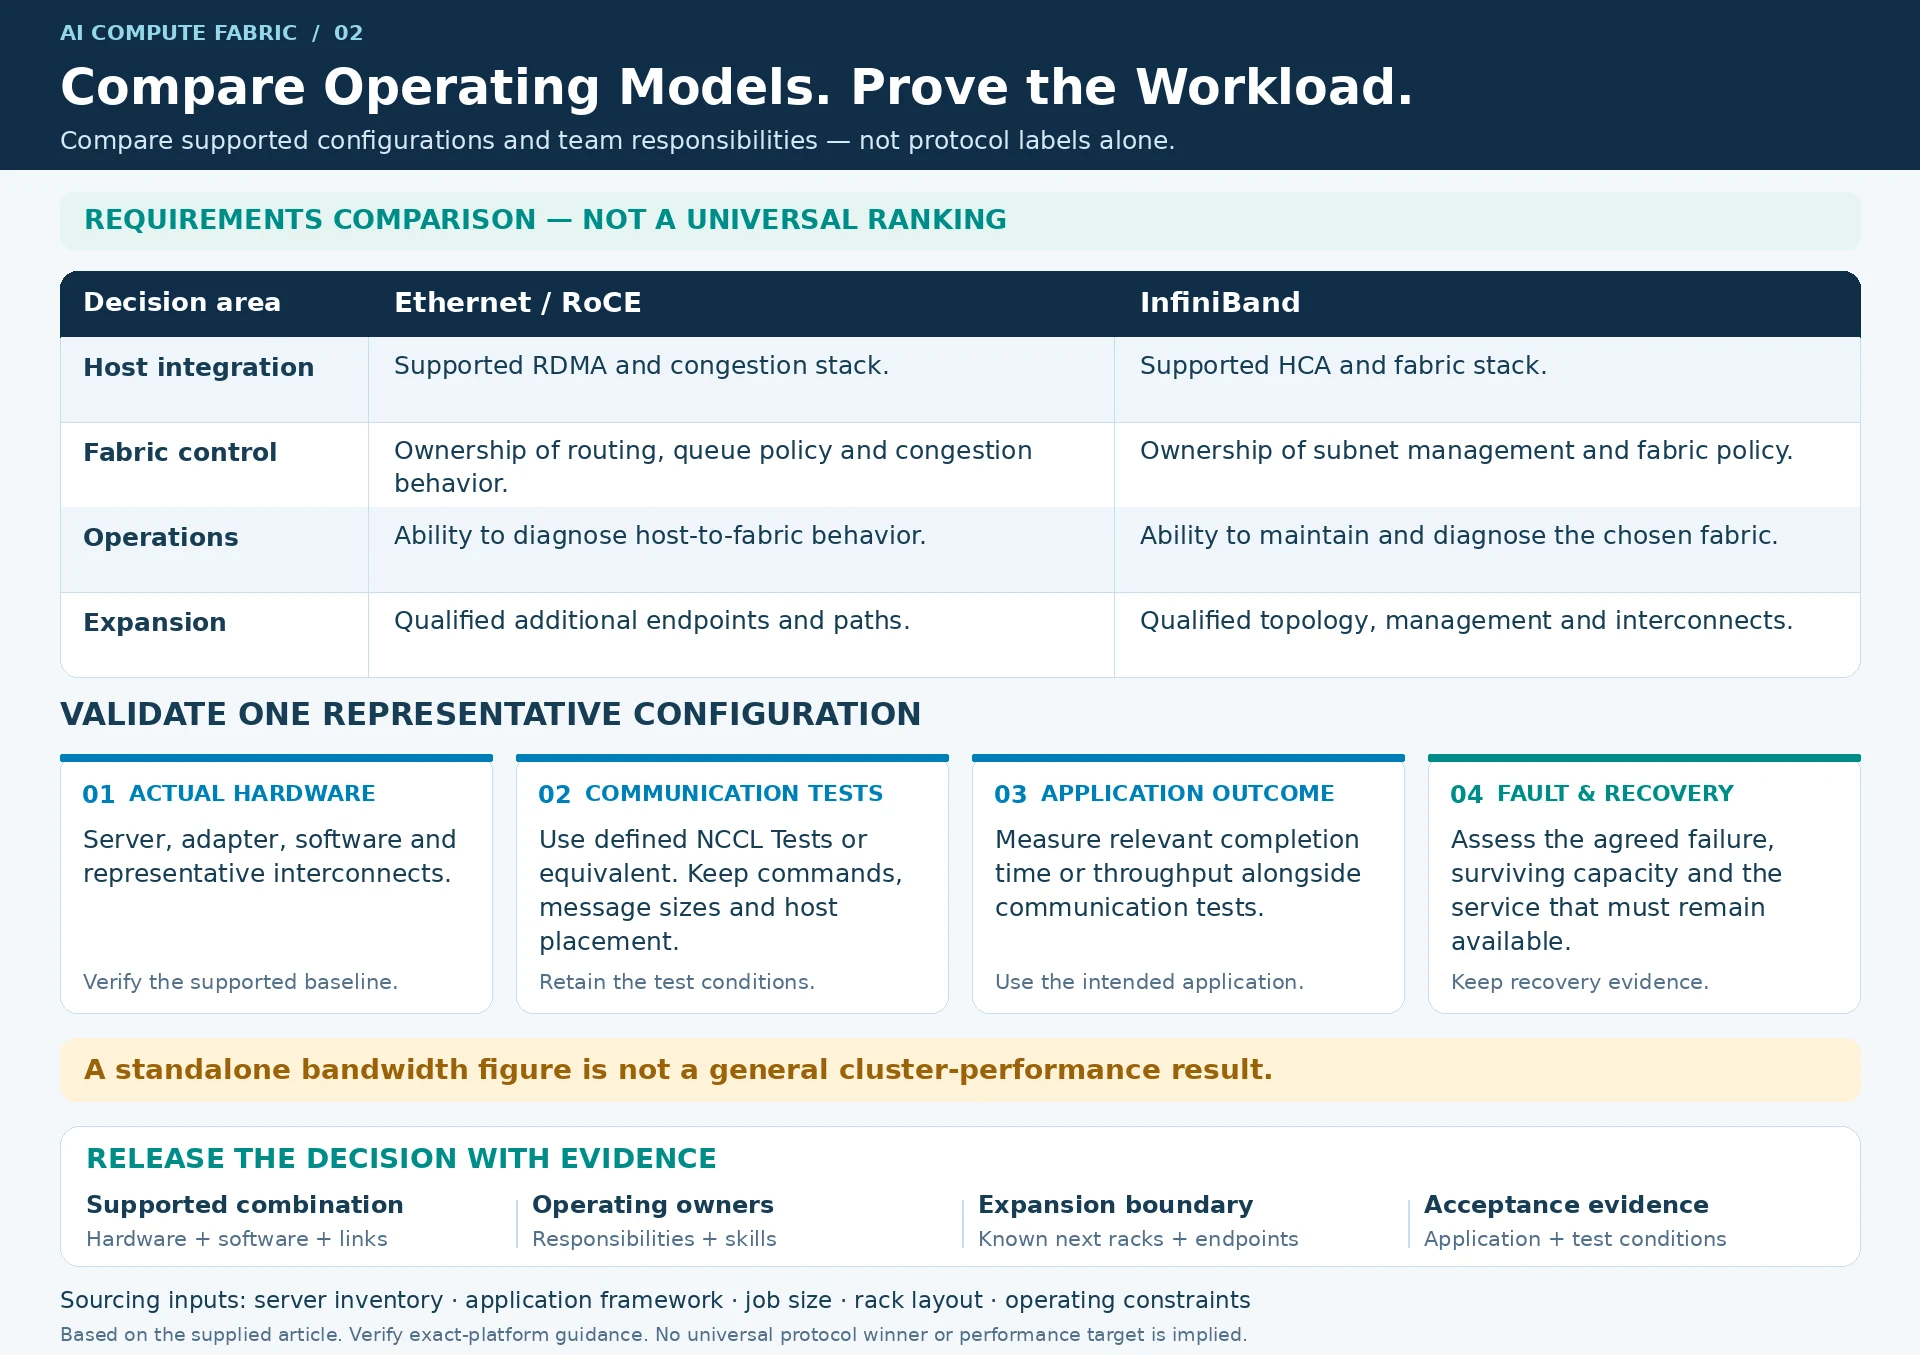
| 决策领域 | 面向以太网/RoCE 设计的问题 | 面向 InfiniBand 设计的问题 |
|---|---|---|
| 主机集成 | 受支持的 RDMA 和拥塞控制栈是否可用? | 受支持的 HCA 和网络架构栈是否可用? |
| 网络架构控制 | 谁负责路由、队列策略和拥塞行为? | 谁负责子网管理和网络架构策略? |
| 运维 | 团队能否诊断主机到网络架构的行为? | 团队能否维护并诊断所选网络架构? |
| 扩展 | 额外的端点和路径是否经过验证? | 拓扑、管理和互连是否经过验证? |
这是需求层面的比较,而非普适的排名。针对每种候选架构,请使用相关厂商的部署指南。R08R52
根据作业放置和增长来设计拓扑
分别计算面向端点的端口和交换机之间的端口。说明收敛比假设,并展示在约定的故障情况下可用的容量。小型单级设计与多级设计对端口的消耗方式不同;在不重新审视网络架构的情况下扩展服务器数量,可能会使最初的假设失效。
为既定的扩展步骤预留容量。“面向未来”不是工程量化指标;一份记录在案、计划增加已知数量机架和端点的方案才是。
验证代表性配置
搭建一个包含实际主机硬件、软件和代表性互连的试点。在通信测试之外,衡量应用的相关结果。对于集合通信工作负载,应保留 NCCL 测试设置和主机放置方式,而不是将孤立的带宽数字作为通用集群结果来呈现。R11
最终建议应明确受支持的配置、预期的运维职责、扩展边界以及验收所需的证据。一份有用的采购需求应包含服务器清单、应用框架、作业规模、机架布局和运维约束。这些信息对网络架构决策的支持,远胜于一份索要最快交换机的请求。
配套工程示意图
以下配图用于说明本篇设计思路,图中英文术语可结合文末释义阅读;不代表实测结果、认证配置或随货清单。
专业术语说明
- RoCE(基于融合以太网的远程直接内存访问)RDMA over Converged Ethernet
- 在以太网上承载 RDMA(远程直接内存访问)的协议。数据传输可由适配器卸载,减少处理器参与和内核数据复制;并非所有过程都完全绕过 CPU。部署时需核对端点、拥塞控制和整条路径。
- InfiniBand(无限带宽)InfiniBand
- 一种面向高性能计算的网络技术,拥有独立的子网管理和网络架构栈。本文将其与以太网/RoCE 并列比较,关注主机集成、网络架构控制和运维职责的差异。
- HCA(主机通道适配器)Host Channel Adapter
- InfiniBand 网络中服务器侧的网络接口设备,承担主机与网络架构之间的连接。本文强调需针对具体适配器确认受支持的 HCA 和网络架构栈是否可用。
- NCCL(NVIDIA 集合通信库)NVIDIA Collective Communications Library
- 用于 GPU 间集合通信的库,常用于训练工作负载的通信测试。本文建议在验证时保留 NCCL 测试设置和主机放置方式,避免将孤立带宽数字当作通用集群结果。
- 收敛比(超售比)oversubscription
- 本篇指下联端口总标称带宽与可用上联或内部汇聚带宽的比值。大于 1:1 表示所有下联同时满速时可能竞争共享容量;正常状态与故障状态应分别计算,计算结果并非实测吞吐量。
- 集合通信collective
- 多个计算节点协同完成的数据交换模式,如训练中的梯度同步。本文指出同步训练集合通信是决定网络需求的重要工作负载特征之一,需与推理、存储等流量区分。
延伸阅读
资料来源
资料核对:
参数、兼容性与操作步骤应结合文中引用资料、完整型号及实际软件版本核对。配图为工程示意。