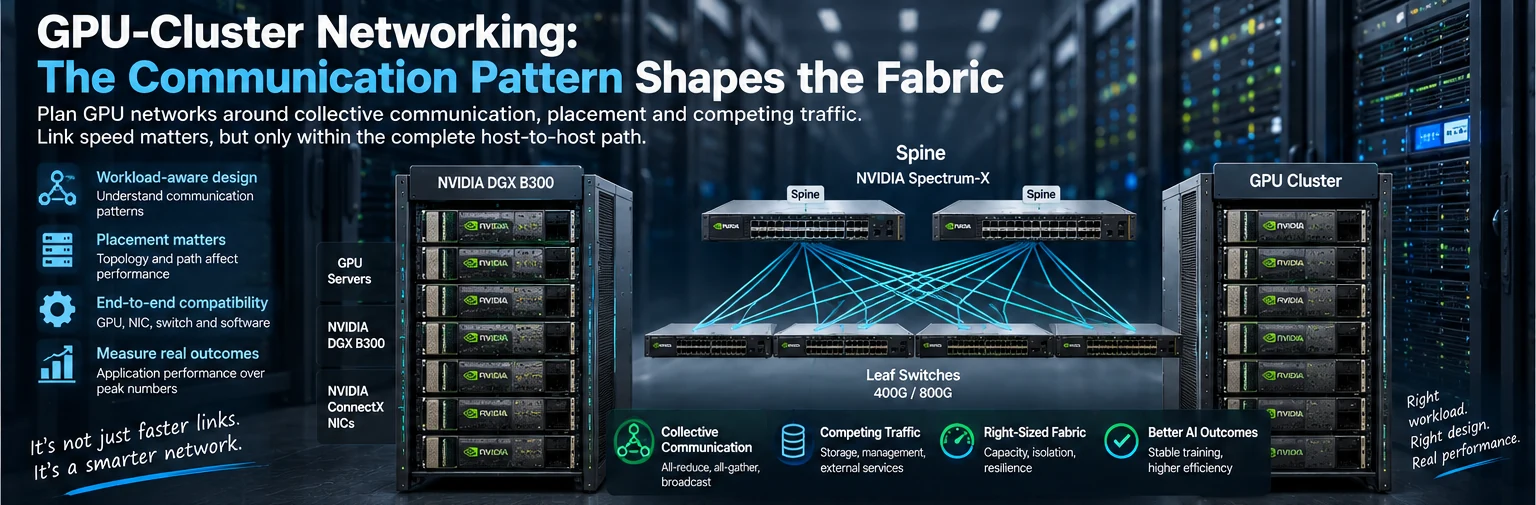
GPU 集群并非简单地把一组高速服务器连接到一台高速交换机上。其网络需求取决于工作如何划分、节点何时交换数据,以及哪些其他服务共享该路径。
这就是为什么 GPU 数量相同的两个集群可能需要不同的网络架构。工作负载和放置模型比单纯的端口速率标签提供了更有用的出发点。
通信是工作负载的一部分
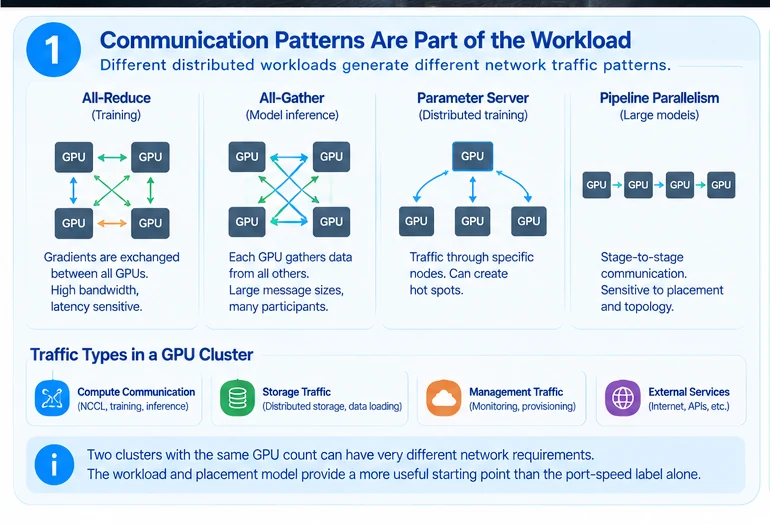
分布式应用交换数据的模式不同于普通的独立客户端请求。集合通信操作可能涉及许多参与方,其行为取决于消息大小、进程放置和拓扑结构。NVIDIA 的集合通信测试工具在衡量通信时将这些变量显式化。R11
设计应记录哪些作业必须跨机架运行,以及它们交换数据的频率。还应区分计算通信与存储访问、外部服务流量和管理流量。共享基础设施是一种设计选择,需要容量和隔离假设,而不是拥有可用端口后的默认结果。
放置会改变网络路径
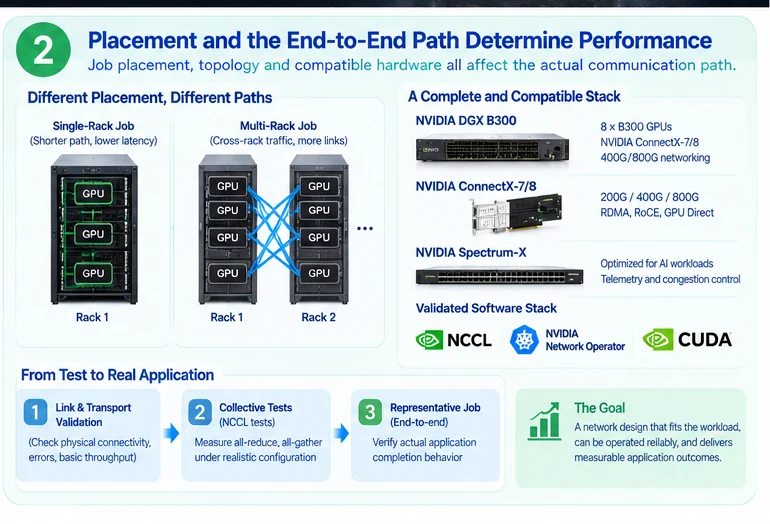
一个示例性工作负载局限在一个机架内,当其下一次运行跨越多个机架时,可能会经过不同的链路集合。即使进程数量相同,瓶颈和故障暴露也可能发生变化。
这使得作业放置和网络拓扑成为相关的运维决策。容量模型应识别在代表性放置下使用的路径,而不仅仅是统计端点数量。它应说明当首选放置不可用或网络组件发生故障时会发生什么。
服务器边界很重要
适配器、主机连接和软件必须支持预期的通信路径。GPU 型号名称并不能标识完整的服务器网络配置。例如,NVIDIA 的 DGX B300 文档描述了一个具有定义接口的完整系统;不应将其简化为对任何包含类似命名 GPU 的服务器的假设。R40
使用适用的服务器和适配器支持参考,并保留实际的软件基线。NVIDIA 的版本化平台矩阵表明,经过测试的组合比宽泛的产品系列描述要窄得多。R10
集成只有在所提议的组合实际使用时才有用
AI 网络平台可以协调交换机、适配器和软件。NVIDIA 将 Spectrum-X 描述为这样一个平台。这种定位并不验证任意组件组合,也不保证针对不同工作负载的供应商宣称的改进。R58
确定所依赖的功能、其先决条件以及将证明其处于活动状态的测试。包括谁在服务器和网络团队之间拥有配置权。
| 规划层 | 需要回答的问题 |
|---|---|
| 工作负载 | 哪些交换决定作业进展? |
| 放置 | 哪些机架和路径参与? |
| 主机 | 预期的适配器和软件路径是否受支持? |
| 网络架构 | 流量可能在哪里集中或失去容量? |
| 运维 | 配置、遥测和恢复如何协调? |
衡量应用结果
从物理层和传输层验证开始,然后运行可重复的集合通信测试和代表性作业。在受控基线条件下比较完成行为,而不仅仅是峰值带宽结果。
良好的 GPU 网络设计应解释其容量、拓扑和运营模式为何适合通信模式。更快的端口可能是答案的一部分,但决定它们能否解决问题的是工作负载——而非营销代际。
配套工程示意图
以下配图用于说明本篇设计思路,图中英文术语可结合文末释义阅读;不代表实测结果、认证配置或随货清单。
专业术语说明
- 集合通信collective communication
- 分布式计算中多个进程共同参与的数据交换模式,如广播、归约、全交换等。其性能受消息大小、进程放置和拓扑影响,是 GPU 集群网络规划的核心依据。
- 网络架构fabric
- 数据中心内连接服务器、交换机等设备的整体网络拓扑与交换结构。本文强调 fabric 需求由通信模式决定,而非仅由端口速率决定。
- 放置placement
- 作业或进程在物理节点、机架间的分布方式。放置变化会改变网络路径、瓶颈和故障暴露,因此需与拓扑协同规划。
- 适配器adapter
- 服务器中负责网络连接的硬件组件,如网卡。其型号与主机连接方式必须与预期通信路径匹配,不能仅凭 GPU 型号推断。
- 软件基线software baseline
- 经过验证并记录在案的软件版本组合,包括驱动、固件、库等。保留实际基线可确保通信路径受支持且可复现。
- 遥测telemetry
- 对网络设备、链路和主机性能指标的持续采集与监控。用于发现流量集中、容量损失和故障,是运维协调的关键部分。
资料来源
资料核对:
参数、兼容性与操作步骤应结合文中引用资料、完整型号及实际软件版本核对。配图为工程示意。